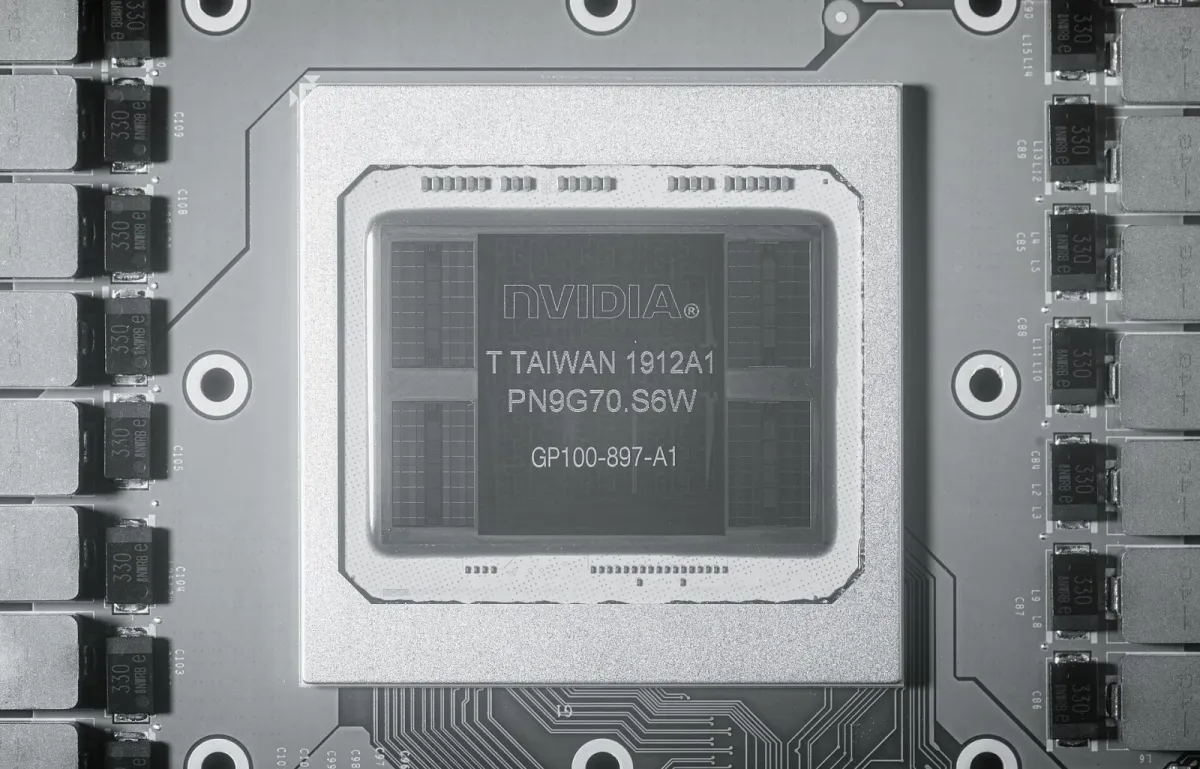
Lange galt das Gehäuse eines Chips als Nebensache: Es schützt den Siliziumkristall und verbindet ihn elektrisch mit der Platine. Bei KI-Beschleunigern ist daraus eine eigene Hightech-Disziplin geworden – und einer der engsten Flaschenhälse der Halbleiterbranche. Wie Reuters am Freitag berichtet, fließen derzeit Milliarden in sogenanntes Advanced Packaging, weil die Nachfrage nach KI-Chips die verfügbare Kapazität übersteigt. Um Packaging habe man sich früher schlicht keine Gedanken gemacht, sagte der frühere Intel-Chef Pat Gelsinger laut Reuters vor Journalisten in Taipeh. Er schätzt, dass es künftig bis zur Hälfte des Werts eines Chipprodukts ausmachen könnte, weil manche GPUs und CPUs heute zehn oder mehr, teils bis zu 20 einzelne Chips vereinen.
Warum ein einzelner Die nicht mehr reicht
Ein Grund ist eine harte physikalische Grenze. Ein EUV-Belichter wie ASMLs NXE:3400C bildet pro Belichtung maximal ein Feld von 26 mal 33 Millimetern ab, größer kann ein einzelner Chip (Die) praktisch nicht werden. Nvidias Blackwell-GPUs bestehen deshalb aus zwei Dies, die diese Grenze jeweils ausreizen und über eine Chip-zu-Chip-Verbindung mit 10 TByte/s zu einer GPU gekoppelt sind. Bei High-NA-EUV, der nächsten Belichtergeneration, ist das Belichtungsfeld laut ASML sogar nur halb so groß. Zugleich wird es laut Reuters immer schwieriger und teurer, Leistung allein durch kleinere und zusätzliche Transistoren zu gewinnen.
Hersteller zerlegen große Designs deshalb in Chiplets: kleinere Dies, die jeweils im passenden Fertigungsprozess entstehen und erst im Package zum Gesamtsystem werden. Intel nennt als Beispiel seine Data Center GPU Max mit 47 aktiven Kacheln aus fünf Fertigungsprozessen. Der zweite Grund ist der Speicher, denn DRAM entsteht in eigenen Prozessen bei den Speicherherstellern. Damit KI-Rechenwerke genug Daten bekommen, muss er trotzdem so nah und so breit wie möglich angebunden werden.
HBM: Speicher im Stapel
KI-Chips müssen gewaltige Datenmengen zwischen Rechenwerken und Speicher hin- und herschieben. Je schneller das geht, desto schneller lassen sich Modelle trainieren und ausführen. Die Antwort der Branche heißt High Bandwidth Memory (HBM): Mehrere DRAM-Dies werden übereinandergestapelt und durch Silizium-Durchkontaktierungen (Through-Silicon Vias, TSV) verbunden. Nach dem im April 2025 verabschiedeten JEDEC-Standard HBM4 besteht ein Stapel aus bis zu 16 Lagen mit bis zu 64 GByte. Er kommuniziert über eine 2048 Bit breite Schnittstelle mit bis zu 8 Gbit/s pro Leitung, das ergibt bis zu 2 TByte/s pro Stapel.
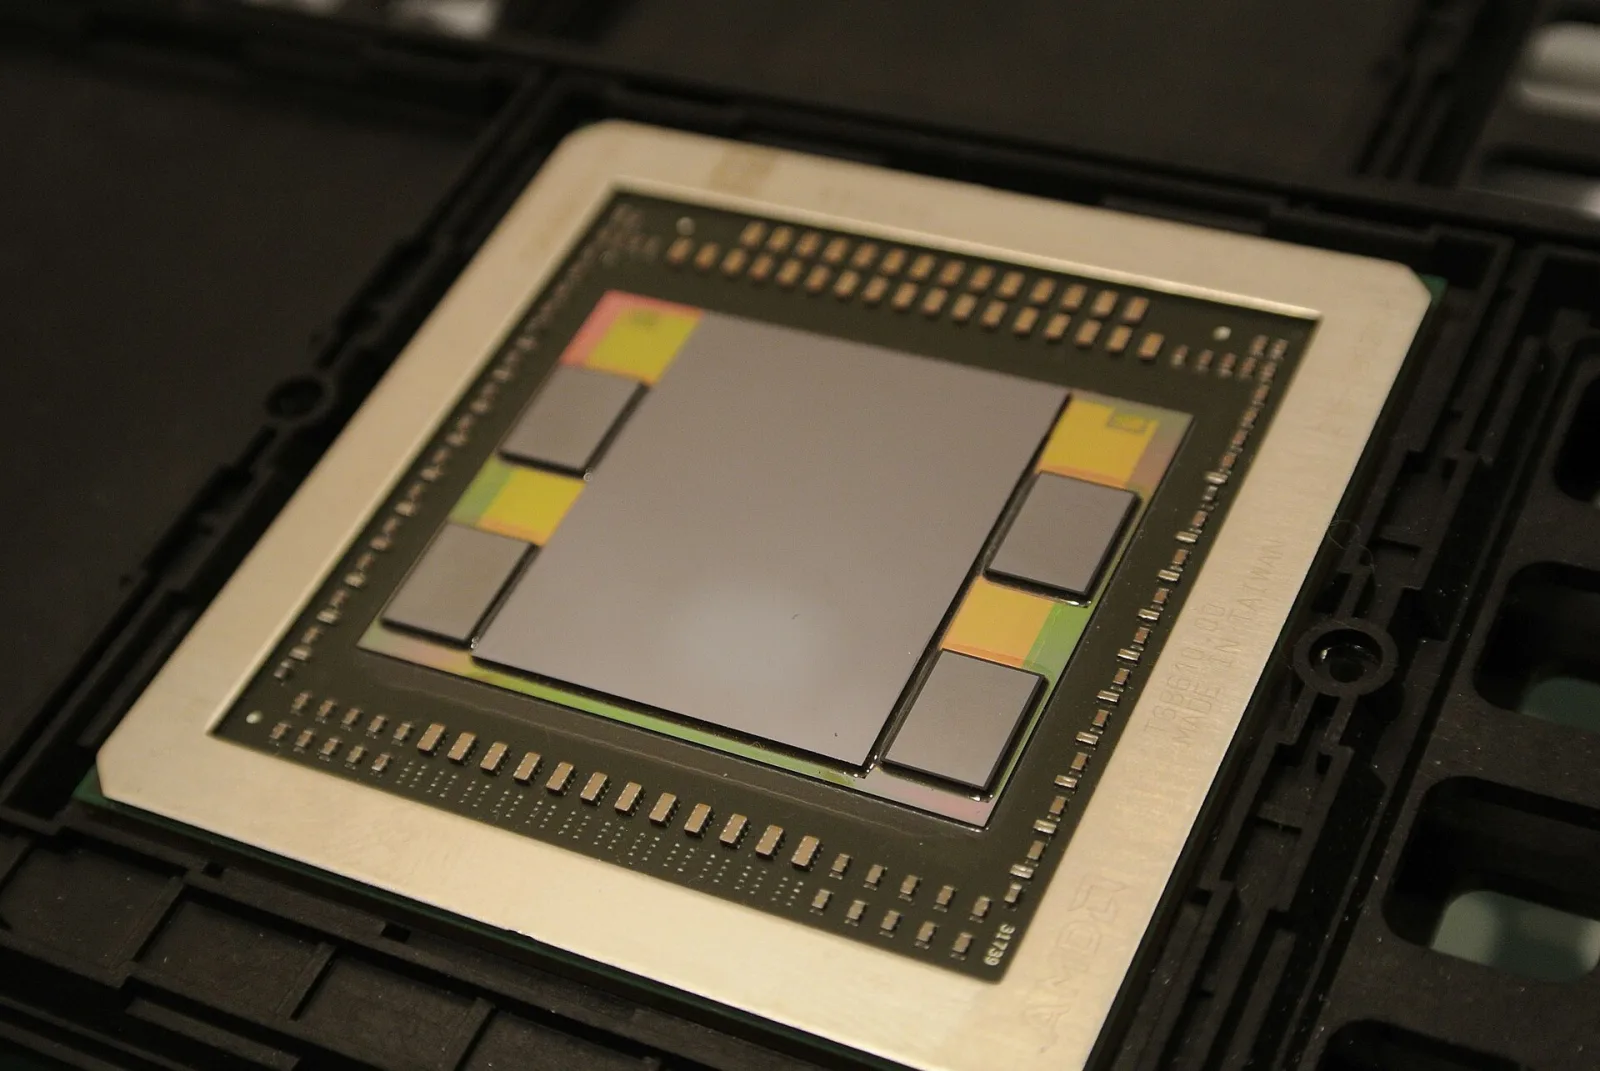
Bild: Package der AMD-GPU Fiji (Radeon R9 Fury X) mit GPU-Die, vier HBM-Stapeln und Interposer – Foto: C. Spille/pcgameshardware.de, Lizenz CC BY-SA 4.0, via Wikimedia Commons

So breite Schnittstellen brauchen Tausende sehr feiner Leitungen. Die liefern Zwischenschichten (Interposer) oder eingebettete Siliziumbrücken, deshalb sitzen die HBM-Stapel direkt neben dem Rechenchip im selben Package. AMDs Beschleuniger Instinct MI355X etwa bindet acht HBM3E-Stapel mit je zwölf Lagen an, zusammen 288 GByte mit bis zu 8 TByte/s.
2,5D: Interposer, Brücken und CoWoS
Beim 2,5D-Packaging liegen die Chips nebeneinander auf einem Interposer, einer dünnen Zwischenschicht mit sehr feiner Verdrahtung, die ihrerseits auf dem Package-Substrat sitzt. TSMCs Chip-on-Wafer-on-Substrate (CoWoS) beschreibt genau diesen Aufbau. Die Varianten unterscheiden sich vor allem im Material der Zwischenschicht:
- CoWoS-S nutzt einen durchgehenden Silizium-Interposer und ist die teuerste Variante. Nvidias H100 und H200 sowie AMDs MI300 setzen darauf. Laut TrendForce fasst CoWoS-S zwei Rechen-Dies und acht HBM-Stapel, bei größeren Interposern stößt die Fertigung an physikalische Grenzen.
- CoWoS-R ersetzt das Silizium durch eine Zwischenschicht aus Umverdrahtungslagen (Redistribution Layer, RDL).
- CoWoS-L kombiniert einen RDL-Interposer mit kleinen eingebetteten Siliziumbrücken (Local Silicon Interconnect) dort, wo Dies besonders dicht verbunden werden müssen. Das erlaubt größere Packages. Nvidia nutzt für Blackwell nach Angaben von Firmenchef Jensen Huang weitgehend CoWoS-L. TrendForce erwartet, dass die Variante bis 2028 der Standard für KI-Chips bleibt.
Intels Gegenentwurf heißt EMIB (Embedded Multi-die Interconnect Bridge): Statt eines großen Interposers stecken kleine Siliziumbrücken direkt im Substrat, laut Intel seit 2017 in Serie. Die neue Variante EMIB-T ergänzt die Brücken um TSVs. Laut TrendForce spart EMIB Kosten, ist aber durch die Leiterbahndichte des Substrats begrenzt. Die Marktforscher erwarten, dass Google EMIB-T ab 2027 einsetzt. Samsung bietet mit Cube-S (Silizium-Interposer), Cube-E (eingebettete Brücken) und Cube-R (RDL) vergleichbare Varianten an.
3D-Stapeln und Hybrid Bonding
Beim 3D-Packaging sitzen Dies direkt übereinander und sind über TSVs verbunden. Klassisch verbinden winzige Lotkontakte (Microbumps) die Lagen. Beim Hybrid Bonding verbinden sich stattdessen die Kupferkontakte und die isolierenden Oberflächen beider Chips direkt miteinander, ganz ohne Lot. Das erlaubt viel engere Raster: AMD nannte 2021 für den mit TSMCs SoIC-Verfahren gestapelten 3D V-Cache einen Kontaktabstand von 9 Mikrometern, gegenüber 50 Mikrometern bei Microbumps und 130 Mikrometern bei klassischen C4-Kontakten. Intel gibt für Foveros Direct weniger als 10 Mikrometer an, Samsung entwickelt nach eigenen Angaben Hybrid Bonding unter 6 Mikrometern. In aktuellen KI-Beschleunigern kommen beide Welten zusammen: Beim MI355X sind acht Rechen-Chiplets vertikal auf zwei I/O-Dies gestapelt, die mit den HBM-Stapeln im selben Package sitzen.
Panel statt Wafer
Bislang dienen runde Wafer als Träger, auf denen sich große rechteckige Packages nur mit Verschnitt unterbringen lassen. Beim Panel-Level-Packaging nutzt man stattdessen große rechteckige Platten. Darauf passen pro Durchgang mehr Chips, und es fällt weniger Material als Abfall an – ein Vorteil, weil KI-Prozessoren immer größer werden. Der taiwanische Packaging-Dienstleister Powertech (PTI) entwickelt die Technik mit AMD und Broadcom und plant ein Joint Venture mit Broadcom in Singapur, in das er 400 Millionen US-Dollar steckt. Die Produktion könnte 2028 beginnen. TSMC hat für seine Panel-Variante CoPoS im April eine Pilotlinie gemeldet und erwartet die Produktion innerhalb weniger Jahre.
Warum es klemmt – und wer investiert
TSMC dominiert die anspruchsvollsten Verfahren, CoWoS nutzen laut Reuters Nvidia, AMD, Broadcom und Cloud-Konzerne mit eigenen KI-Chips. Die Nachfrage nach CoWoS sei weiterhin stark, sagte Finanzchef Wendell Huang Mitte Oktober, man werde für ausreichende Kapazität sorgen. Konkrete Kapazitätszahlen nannte TSMC dabei nicht. Goldman Sachs schätzt die CoWoS-Kapazität laut TrendForce für 2026 auf rund 1,3 Millionen Wafer, gut 100.000 pro Monat, und erwartet für 2027 mehr als eine Verdopplung. Für 2026 plant TSMC Investitionen von 60 bis 64 Milliarden US-Dollar. Im Januar, noch bei einem niedrigeren Budget, hatte der Konzern angekündigt, 10 bis 20 Prozent davon in Advanced Packaging, Tests, Maskenfertigung und Sonstiges zu stecken.
Weil TSMC nicht genug liefern kann, suchen Chipentwickler zusätzliche Partner. Nvidia finanziert laut einem von Reuters zitierten, anonymen Branchenvertreter mit Milliardenbeträgen den Ausbau der CoWoS-Kapazität bei SPIL, einer Tochter des weltgrößten Packaging- und Testdienstleisters ASE. Nvidia antwortete auf eine Anfrage von Reuters nicht. ASE hat sein Investitionsbudget für 2026 auf 11,5 Milliarden US-Dollar erhöht und erwartet mit modernstem Packaging und Test in diesem Jahr 4 Milliarden US-Dollar Umsatz, 2027 das Doppelte. AMD hat in Taiwan Investitionen von mehr als 10 Milliarden US-Dollar angekündigt, darunter Packaging-Partnerschaften mit ASE, SPIL und Powertech. AMD-Chefin Lisa Su nannte CoWoS und Advanced Packaging gegenüber Reuters „super important“ und sagte, man brauche insgesamt mehr Kapazität. In den USA hat Amkor die geplante Investition in seinen Packaging-Standort in Arizona im September auf rund 12 Milliarden US-Dollar erhöht.
Laut dem Marktforscher Yole Group, auf den sich Reuters beruft, übertrifft der Umsatz mit Advanced Packaging 2026 erstmals den mit klassischem Packaging, die Investitionen in die Technik dürften knapp 28 Milliarden US-Dollar erreichen. Auch Ausrüster wie Applied Materials und Tokyo Electron drängen in das Geschäft. Schnelle Entlastung ist trotzdem nicht in Sicht: Panel-Verfahren sollen erst ab etwa 2028 in Serie gehen, Amkors zweite Ausbaustufe in Arizona soll Ende 2029 fertig sein. Bis dahin entscheidet nicht nur die Zahl der belichteten Wafer, sondern auch die verfügbare Packaging-Kapazität darüber, wie viele KI-Beschleuniger auf den Markt kommen.
Quellen
- Reuters (via Yahoo Finance): AI boom turns chip packaging into the next battleground for semiconductors (06.11.2026)
- Focus Taiwan (CNA): TSMC raises 2026 sales growth forecast to 44%, leaves capex unchanged (15.10.2026)
- Focus Taiwan (CNA): ASE raises advanced IC assembly, testing sales forecast for 2026 (30.10.2026)
- Industrial Info Resources: Chipmaker TSMC Projects 2026 Capex will Reach $52 Billion-$56 Billion (19.01.2026)
- TrendForce: After TSMC’s 3Q26 Earnings: Key Brokerage Takeaways as 2028 Capex Forecasts Reach US$105B (16.10.2026)
- TrendForce: AI Chip Packaging Pushes Beyond Reticle Limits, with CoWoS-L Set to Remain the Mainstream Advanced Packaging Solution Through 2028 (18.09.2026)
- TrendForce: Blackwell Enters the Scene – A Closer Look at TSMC’s CoWoS Branch (21.03.2024)
- Reuters (via The Star): Nvidia CEO says its advanced packaging technology needs are changing (16.01.2025)
- Nvidia: Blackwell Architecture
- ASML: TWINSCAN NXE:3400C
- ASML: 5 things you should know about High NA EUV lithography (25.01.2024)
- JEDEC (via HPCwire): JEDEC Releases HBM4 Standard to Advance AI and HPC Memory (16.04.2025)
- AMD ROCm Documentation: AMD Instinct MI350 Series microarchitecture
- Intel Foundry: Advanced Packaging Innovations
- Intel Foundry: Get the Facts About Intel Foundry
- Samsung Semiconductor: Advanced Heterogeneous Integration
- Tom’s Hardware: AMD Unveils More Ryzen 3D Packaging and V-Cache Details at Hot Chips (23.08.2021)
- Evertiq: Amkor expands Arizona campus to $12 billion investment (09.09.2026)
Bildnachweis
- Aufmacher: Nvidia Tesla P100 (GP100), Aufnahme im Nahinfrarot von FritzchensFritz, Lizenz CC0 1.0, via Wikimedia Commons
- Im Text: AMD Fiji GPU package with GPU, HBM memory and interposer von C. Spille/pcgameshardware.de, Lizenz CC BY-SA 4.0, via Wikimedia Commons
