Der französische KI-Hersteller Mistral AI hat am 29. Oktober die Gewichte von Mistral Large 4 freigegeben. Das multimodale Sprachmodell, das Mistral selbst „Le Chonk“ nennt, umfasst rund eine Billion Parameter und ist das bislang größte Modell des Pariser Unternehmens. Die Dateien liegen auf Hugging Face, der Betrieb auf eigener Infrastruktur ist ausdrücklich vorgesehen. Seit dem 6. Oktober ließ sich Mistral Large 4 nur als Vorschau über Mistrals API nutzen; die Gewichte hatte der Hersteller damals für Ende des Monats angekündigt.
Seit der Vorschau hat Mistral das Modell nach eigenen Angaben drei weitere Wochen mit Reinforcement Learning trainiert. Laut Forschungschef Pierre Stock braucht die neue Fassung bei gleicher Leistung rund 50 Prozent weniger Token, wie er heise online sagte.
Mixture of Experts mit 49 oder 52 Milliarden aktiven Parametern
Mistral Large 4 ist ein Mixture-of-Experts-Modell (MoE): Pro Token rechnet nur ein kleiner Teil des Netzes. Laut Modellkarte leitet ein Router jedes Token an 4 von 128 Experten weiter, hinzu kommt ein gemeinsamer Experte. Aktiv sind so 49 Milliarden Parameter pro Token; zählt man Embeddings und Ausgabeschichten mit, sind es 52 Milliarden. Daher stammen die unterschiedlichen Zahlen in Berichten. Das Kontextfenster fasst eine Million Token. Das Modell verarbeitet Text und Bilder und antwortet mit Text; nach Mistrals Angaben beherrscht es mehr als 160 Sprachen, darunter alle Amtssprachen der EU.
Neu sind drei Reasoning-Stufen: „low“ ersetzt den bisherigen Modus ohne Reasoning, „medium“ ist für Alltagsaufgaben gedacht, „high“ ist voreingestellt. Außerdem enthält der Checkpoint einen Entwurfskopf für spekulatives Dekodieren, den Mistral „DSpark“ nennt: Drei zusätzliche Schichten schlagen jeweils einen Block aus drei Token vor, den das Hauptmodell anschließend prüft. Das soll den Durchsatz laut Mistral um bis zu den Faktor 1,9 erhöhen, ohne die Ausgaben des Modells zu verändern.
Lizenz: frei nutzbar – außer für Model-as-a-Service-Anbieter
Mistral veröffentlicht das Modell unter der „Mistral Ecosystem Open-Weight License“, einer abgewandelten MIT-Lizenz. Sie erlaubt, das Modell zu nutzen, zu kopieren, zu verändern, weiterzutrainieren, weiterzugeben und zu verkaufen; Grundbedingung ist der Copyright- und Lizenzhinweis. Entscheidend ist Abschnitt 2: Betreibt der Lizenznehmer oder ein mit ihm verbundenes Unternehmen ein „Model as a Service“-Geschäft, braucht er vor jeder kommerziellen Nutzung des Modells oder davon abgeleiteter Modelle eine separate kommerzielle Lizenz von Mistral.
Als Model as a Service gilt laut Lizenztext, Dritten Zugriff auf das Modell für Inferenz oder Nachtraining zu geben – etwa per API oder gehostetem Endpunkt –, sofern diese wesentlichen Einfluss auf Eingaben, Parameter oder Trainingsdaten haben. Ausgenommen sind Endkundenprodukte, in denen das Modell nur in bestimmte Funktionen eingebettet ist, sowie das bloße Weiterreichen von Anfragen an Modelle, die andere hosten. Ganz von der Pflicht befreit sind die interne Nutzung, bei der das Modell keinem Dritten zur Verfügung steht, und die Nutzung über Mistrals eigene Produkte. Wer Mistral Large 4 also im eigenen Unternehmen betreibt oder fest in eine Anwendung einbaut, braucht keine Zusatzlizenz; Hosting-Anbieter, die es als frei ansprechbares Modell vermieten, schon. Eine Open-Source-Lizenz im klassischen Sinn, die keine Nutzergruppe ausschließt, ist das trotz MIT-Basis nicht – entsprechend trägt die Lizenz „Open-Weight“ im Namen.
Selbst betreiben: FP8, NVFP4 und GGUF
Für den Eigenbetrieb gibt es zwei offizielle Checkpoints. Der Hauptcheckpoint liegt in FP8 vor und belegt auf Hugging Face rund 1,06 TByte. Eine NVFP4-Fassung kommt auf etwa 610 GByte; sie zielt laut Modellkarte auf Nvidias Blackwell-Generation (B200, B300, GB200 und GB300), die das Format in Hardware beschleunigt, und soll in Mistrals Tests ebenso genau arbeiten wie FP8. Als Inferenz-Software empfiehlt Mistral vLLM, unterstützt werden außerdem SGLang, Hugging Face Transformers und llama.cpp.
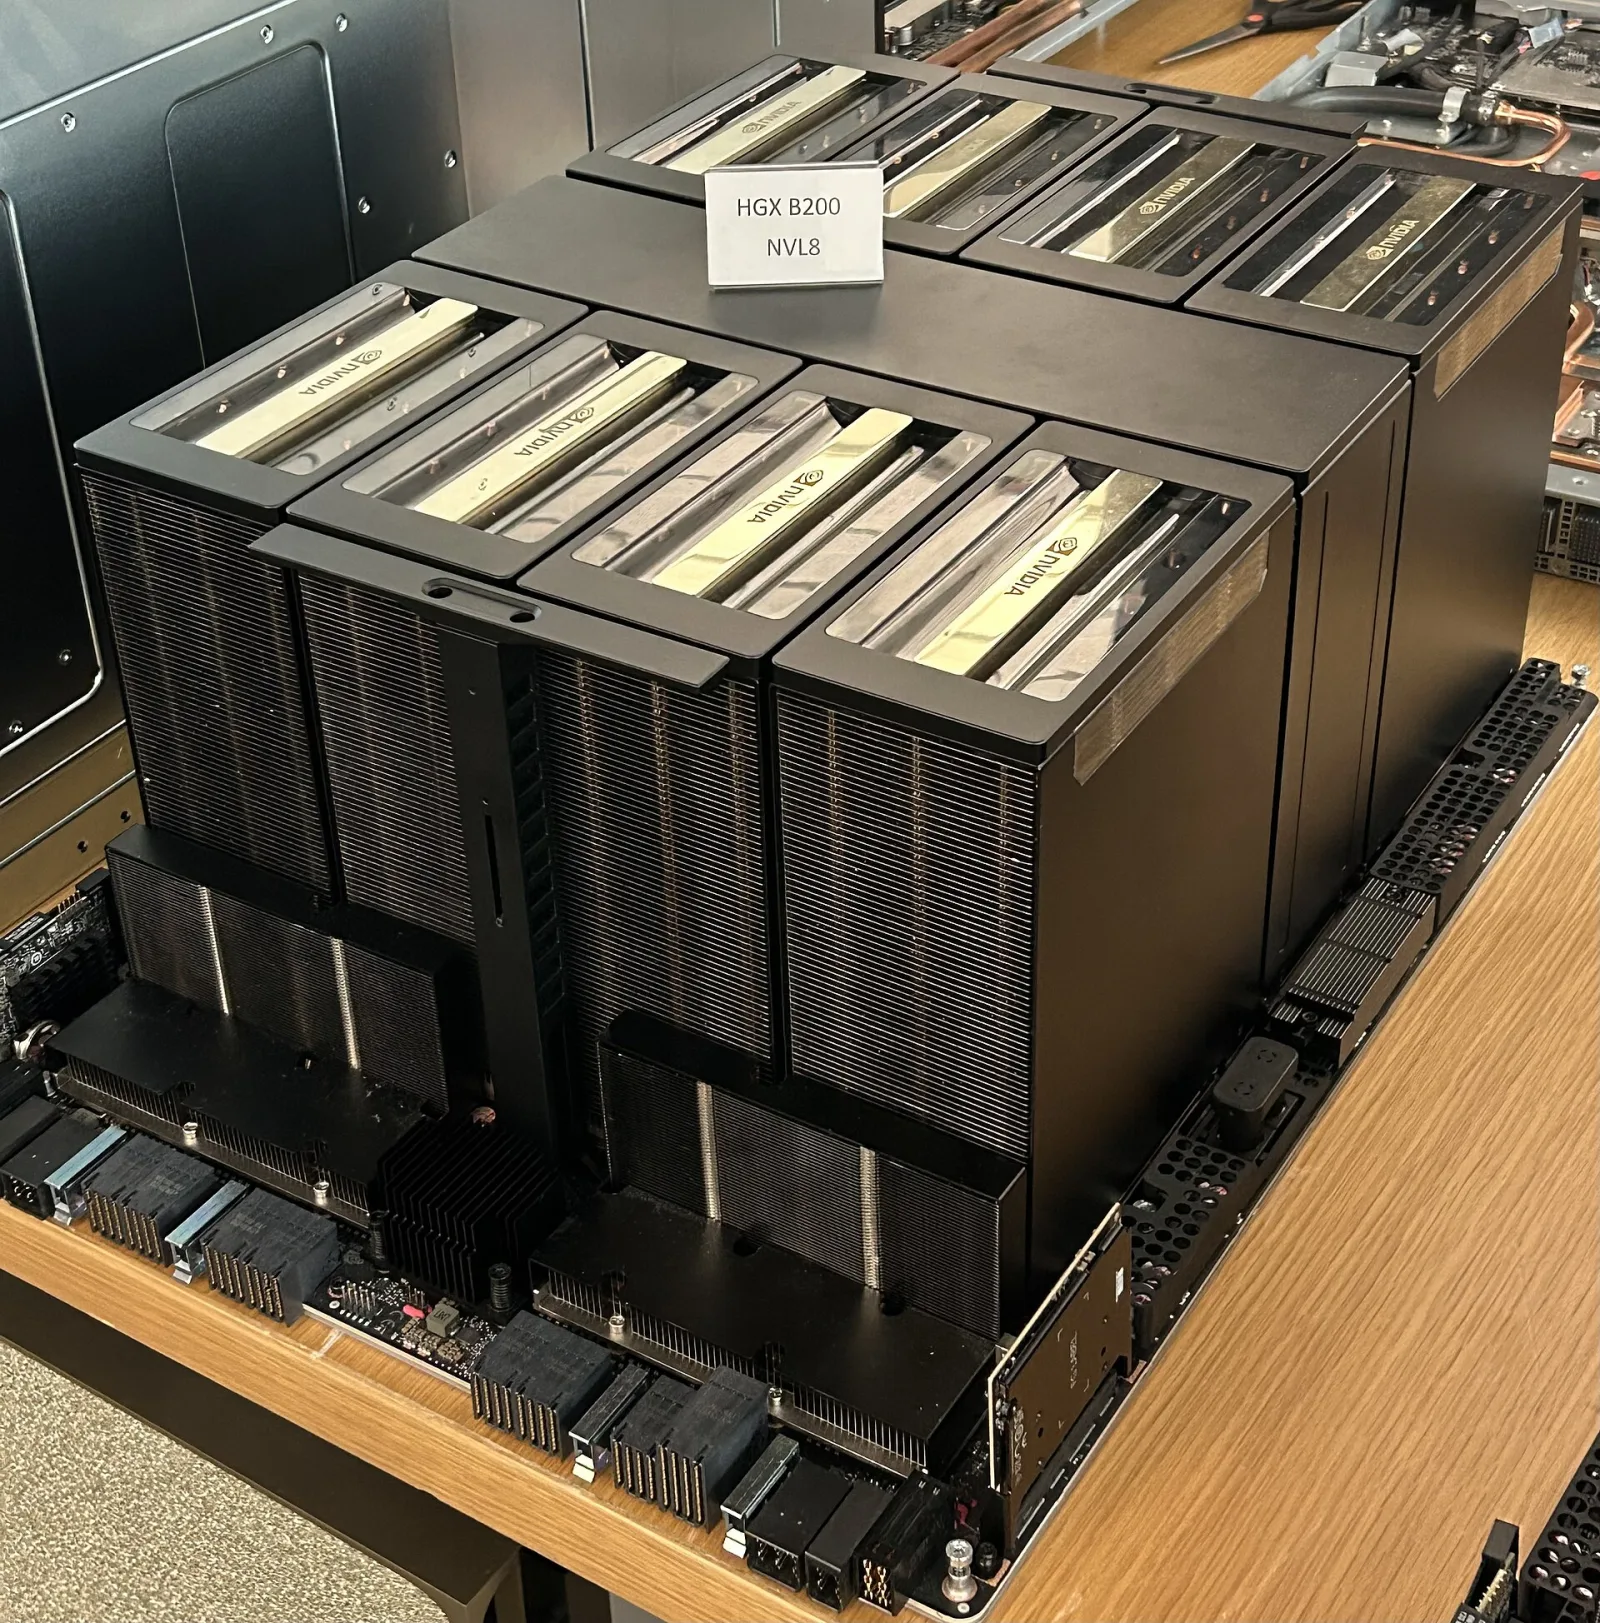
Bild: Acht Blackwell-GPUs auf einem HGX-B200-Board – Hardware dieser Klasse braucht Mistral Large 4. Foto: Pokiiri / Wikimedia Commons, CC BY-SA 4.0

Billig wird der Eigenbetrieb nicht. Die Beispielkonfigurationen der Modellkarte verteilen das FP8-Modell per Tensor-Parallelität auf acht GPUs – rechnerisch rund 130 GByte Gewichte pro Karte, bevor der KV-Cache dazukommt. Für die NVFP4-Variante nennt Mistral einen Blackwell-Knoten mit vier GPUs als Beispiel; laut The Next Web läuft die quantisierte Version auf vier Nvidia B200 oder B300. Auch die GGUF-Dateien für llama.cpp, die das Projekt ggml-org bereitstellt, bleiben gewaltig: Die 4-Bit-Variante Q4_K_M ist rund 635 GByte groß, die kleinste Quantisierung IQ2_XXS knapp 300 GByte. Der Start mit vLLM sieht laut Modellkarte so aus:
docker run --runtime nvidia --gpus all \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -p 8000:8000 --ipc=host \
  vllm/vllm-openai:mistral-large-4 \
  --model mistralai/Mistral-Large-4-1T-A52B \
  --tensor-parallel-size 8 \
  --tool-call-parser mistral --reasoning-parser mistral \
  --enable-auto-tool-choice --gpu-memory-utilization 0.85
Wer keine eigenen Beschleuniger hat, kann das Modell über Mistrals API nutzen: Sie kostet 0,70 US-Dollar pro Million Eingabe-Token (0,07 US-Dollar aus dem Cache) und 2,10 US-Dollar pro Million Ausgabe-Token. Daneben ist Mistral Large 4 über OpenRouter, Microsoft Foundry und von Nvidia gehostete Endpunkte erreichbar.
Benchmarks: stark beim Programmieren, im Gesamtindex hinter China
Mistral bezeichnet Large 4 als bestes offenes Modell fürs Programmieren. Nach Herstellerangaben erreicht es in Cognitions nicht öffentlichem Benchmark FrontierCode 2.0 19,7 Prozent und im Terminal-Bench 4.0 41 Prozent, 13 Prozentpunkte mehr als die Vorschau. Im Coding Agent Index von Artificial Analysis liege es mit 48 Prozent etwa gleichauf mit dem chinesischen GLM-5.3, verbrauche aber im Schnitt 47 Prozent weniger Token. Für den Cyber Index von Artificial Analysis nennt Mistral 51 Prozent; bösartige Cyber-Anfragen lehne das Modell in eigenen Tests zu 96,6 Prozent ab.
Die unabhängigen Messungen von Artificial Analysis relativieren das Bild, wie The Decoder und VentureBeat am Veröffentlichungstag berichteten. Im allgemeinen Intelligence Index v5 kommt Mistral Large 4 auf 26 Punkte (Vorschau: 25) – der beste Wert unter den offenen Modellen außerhalb Chinas, aber klar hinter GLM-5.3 und DeepSeek V4.1 Flash mit je 32 Punkten. Im Cyber Index liegt es unter den offenen Modellen hinter DeepSeek V4.1 Flash und Xiaomis MiMo-V2.6-Pro auf Platz drei. Deutlich verbessert hat sich die Effizienz: Laut VentureBeat misst Artificial Analysis rund 63 Prozent niedrigere Kosten für seine Testaufgaben als bei der Vorschau. In Mistrals Vergleichen fehlt Kimi K3.1 Pro von Moonshot AI, laut The Decoder mit 46 Punkten das stärkste offene Modell im Index – dessen Gewichte waren zu diesem Zeitpunkt allerdings noch nicht veröffentlicht.
Beim Thema Sicherheit räumt Mistral selbst ein Risiko ein: Man habe seit der Vorschau den Live-Verkehr beobachtet und sehe ein Potenzial, echte Angriffe zu erleichtern; die Schutzmechanismen würden entsprechend angepasst. Eine auf Penetrationstests und Red-Teaming spezialisierte Variante erhalten nur geprüfte Partner wie Orange Cyberdefense unter vertraglichen Auflagen. Nach Angaben in Mistrals Ankündigung testet auch die EU-Cybersicherheitsagentur ENISA das Modell, um Schwachstellen zu finden, Code zu prüfen und Logs auszuwerten.
Einordnung: europäisches Training, amerikanische Chips
Mit Large 4 positioniert sich Mistral als Anbieter „souveräner“ KI für Behörden und Unternehmen, die ihre Modelle selbst kontrollieren wollen. Trainiert wurde das Modell laut Mistral von Grund auf mit 3800 Grace-Blackwell-GPUs von Nvidia in Mistrals eigenen Rechenzentren in Europa; das Reinforcement Learning lief laut The Next Web auf eigener Rechenleistung in Frankreich mit rund 10 Megawatt. Die Infrastruktur steht also in Europa, die Beschleuniger stammen aus den USA. Als erster Cloud-Anbieter hat ausgerechnet Microsoft das Modell auf seiner Plattform Foundry im Angebot.
Finanziell spielt Mistral in einer anderen Liga als die US-Konkurrenz: CEO Arthur Mensch verwies laut SiliconANGLE und The Next Web darauf, dass Mistral in drei Jahren rund 6 Milliarden US-Dollar eingesammelt habe, während andere Labore Hunderte Milliarden aufbrachten. Die jüngste Finanzierungsrunde über 3 Milliarden Euro soll vor allem zusätzliche Rechenkapazität ermöglichen. Zwischen den letzten beiden Flaggschiffmodellen lagen zehn Monate; Stock begründete das gegenüber heise mit dem Aufbau eigener Rechenzentren und dem stärkeren Fokus auf Reinforcement Learning, künftig will Mistral schneller liefern. Ob das reicht, um zu den chinesischen Open-Weight-Modellen aufzuschließen, muss sich zeigen – zumal Moonshot AI die Gewichte von Kimi K3.1 Pro Anfang November ebenfalls auf Hugging Face veröffentlicht hat.
Quellen
- Mistral AI: Mistral Large 4 (Le Chonk) is now open weight (29.10.2026)
- Mistral AI: Introducing Mistral Large 4 (06.10.2026)
- Hugging Face: Modellkarte mistralai/Mistral-Large-4-1T-A52B (29.10.2026)
- Hugging Face: Mistral Ecosystem Open-Weight License (Lizenztext) (29.10.2026)
- Hugging Face: Modellkarte Mistral-Large-4-1T-A52B-NVFP4 (29.10.2026)
- Hugging Face: ggml-org/Mistral-Large-4-1T-A52B-GGUF (29.10.2026)
- heise online: Mistral Large 4: Modellgewichte veröffentlicht, Coding-Leistung verbessert (29.10.2026)
- The Decoder: Paris-based Mistral releases „Le Chonk,“ a strong coding model that still trails China overall (29.10.2026)
- VentureBeat: Mistral Large 4 „Le Chonk“ arrives as the top open model outside China (29.10.2026)
- SiliconANGLE: Mistral releases open weights for Mistral Large 4 (29.10.2026)
- The Next Web: Mistral releases open weights for its 1 trillion-parameter Large 4 model (29.10.2026)
- TechNode: Moonshot AI releases Kimi K3.1 Pro model weights (05.11.2026)
Bildnachweis
- Aufmacher: GPU-Blade mit Glykol-Kühlung aus dem Supercomputer MareNostrum 5 (Symbolbild) von Steve Jurvetson, Lizenz CC BY 4.0, via Wikimedia Commons
- Inline: Nvidia DGX B200 8-way GPU Board (HGX) von Pokiiri, Lizenz CC BY-SA 4.0, via Wikimedia Commons
