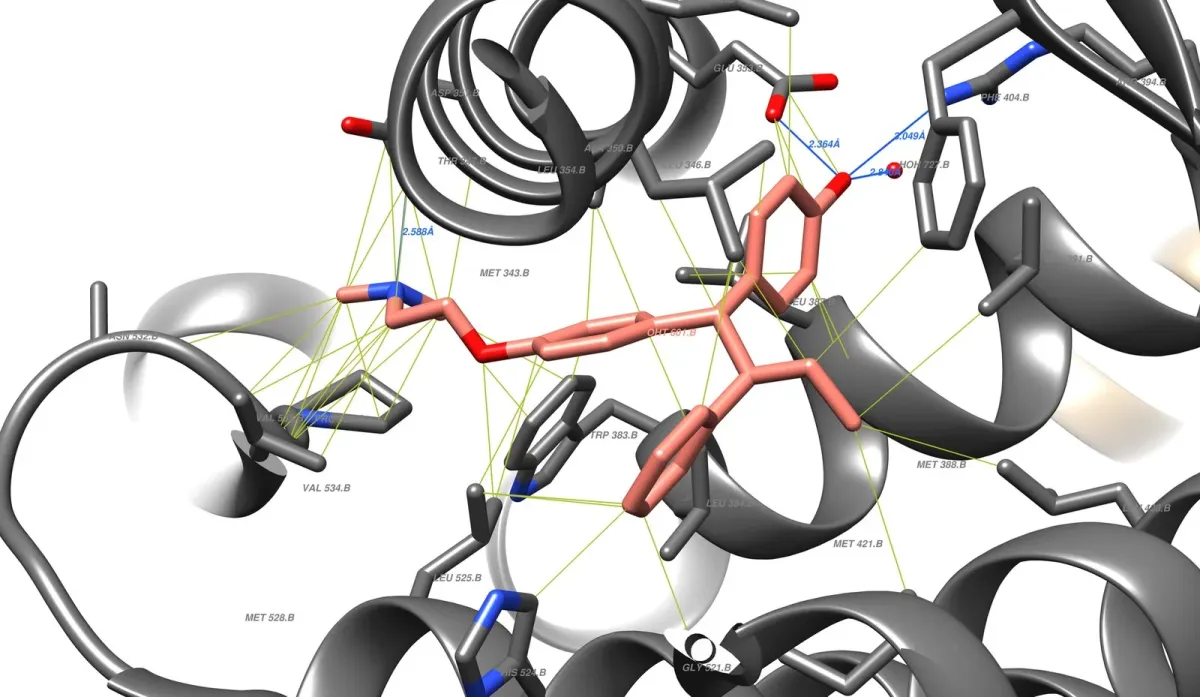
Die wertvollsten Trainingsdaten für KI in der Wirkstoffforschung liegen nicht in öffentlichen Datenbanken, sondern in den Archiven der Pharmakonzerne – und dort bleiben sie, weil kein Unternehmen der Konkurrenz Einblick in laufende Programme geben will. Das Berliner Start-up Apheris will dieses Dilemma mit föderiertem Lernen auflösen und wurde dafür beim Technologiepreis The Spark 2026 von Handelsblatt und McKinsey ausgezeichnet: Laut Handelsblatt belegte es bei der Verleihung am 5. November 2026 den dritten Platz hinter dem Photonik-Start-up Q.ANT und Proxima Fusion. Den Durchbruch sah die Jury demnach nicht in einem neuen KI-Modell, sondern im Zugang zu den Daten.
Apheris wurde 2019 von Robin Röhm und Michael Höh gegründet. Im Januar 2025 sammelte Apheris laut TechCrunch in einer Series-A-Runde unter Führung von OTB Ventures und eCAPITAL 8,25 Millionen US-Dollar ein, insgesamt 20,8 Millionen US-Dollar seit der Gründung.
Föderiertes Lernen: Das Modell reist zu den Daten
Beim föderierten Lernen wandern nicht die Daten zum Modell, sondern das Modell zu den Daten. Jeder Teilnehmer trainiert eine Kopie lokal; zentral zusammengeführt werden nur die Ergebnisse, also Modellparameter. Bei Apheris installiert dafür jeder Dateninhaber eine Software namens Compute Gateway in seiner eigenen Umgebung, laut Dokumentation per Helm-Chart in Kubernetes oder als Einzelinstallation. Ein Agent im Gateway fragt bei einem zentralen Orchestrator regelmäßig nach neuen Aufträgen; Verbindungen gehen nur von innen nach außen, eingehende Verbindungen sind nicht vorgesehen. Eine Datenzugriffsschicht prüft jede Berechnung gegen sogenannte Asset Policies, die der Dateninhaber festlegt: welche Modelle auf welchen Datensätzen laufen dürfen und in welchen Parametergrenzen. Der Orchestrator speichert nur Metadaten und den Ablageort eines Datensatzes, nie die Daten selbst.
Für das Training selbst nutzt Apheris das quelloffene Framework NVIDIA FLARE: Auf dem Orchestrator läuft ein FLARE-Server, auf jedem Gateway ein FLARE-Client. Der Server führt die lokal trainierten Parameter zusammen, etwa per Federated Averaging (Mittelung), und verteilt das aktualisierte Modell wieder an alle Teilnehmer.
Der Praxistest: OpenFold3 mit 20.000 Pharma-Strukturen
Was das bringt, zeigt das AI Structural Biology Network (AISB), ein von der Industrie geführter Verbund, den Apheris technisch betreibt. Im März 2025 kündigte Apheris an, das öffentlich verfügbare Strukturmodell OpenFold3 aus dem Labor von Mohammed AlQuraishi an der Columbia University mit Daten von AbbVie und Johnson & Johnson nachzutrainieren; im Oktober 2025 kamen Astex Pharmaceuticals, Bristol Myers Squibb und Takeda hinzu. Laut TechCrunch gehörten dem Konsortium Anfang 2025 auch Boehringer Ingelheim und Sanofi an; nach Apheris-Angaben umfasst das Netzwerk inzwischen neun Pharmaunternehmen, die nicht alle öffentlich genannt sind. OpenFold3 ist ein Co-Folding-Modell: Es sagt voraus, wie ein Protein und ein Wirkstoffmolekül gemeinsam räumlich angeordnet sind.
Die Ergebnisse veröffentlichte Apheris am 14. September 2026. Die fünf am OpenFold3-Projekt beteiligten Firmen hatten OpenFold3 Preview 2 jeweils lokal auf zusammen 20.167 eigenen, experimentell bestimmten Strukturen aus laufenden Wirkstoffprogrammen nachtrainiert. Getestet wurde das resultierende Modell AISB-1-Fed an 1.056 zurückgehaltenen Strukturen der Partner. Der Anteil der Vorhersagen mit hochwertiger Kontaktfläche zwischen Protein und Ligand (PL-lDDT ≥ 0,8) stieg von 35,6 auf 52,1 Prozent, der Anteil korrekt platzierter Liganden (Abweichung höchstens 2 Ångström) von 28,9 auf 46,8 Prozent. Vor dem stärksten öffentlichen Vergleichsmodell Boltz-2 lag AISB-1-Fed nach Apheris-Angaben bei beiden Kennzahlen rund 11 Prozentpunkte vorn. Ein Kontrollmodell, das nur mit allen öffentlichen Daten der Proteindatenbank PDB nachtrainiert wurde, schnitt schlechter ab; Apheris folgert daraus, dass der Gewinn auf die privaten Strukturen zurückgeht. Nature berichtete am selben Tag, das System übertreffe AlphaFold-ähnliche Modelle, die nur öffentliche Daten nutzen.
Bild: Symbolbild – Proteinkristalle für die Röntgenkristallographie, aus der experimentell bestimmte Strukturen stammen. Foto: CSIRO / Wikimedia Commons, CC BY 3.0

Laut einem Apheris-Bericht vom März 2026 trainierte das Netzwerk fast einen Monat lang auf zehn AWS-Instanzen vom Typ p5.48xlarge mit zusammen 80 Nvidia-H100-GPUs. Gearbeitet wurde synchron: Alle zehn Optimierungsschritte wurden die Parameter zusammengeführt, ein Update pro Firma ist laut Apheris rund 2 GByte groß. Weil jede Runde auf den langsamsten Teilnehmer wartet, rechnet Apheris vor, summiere sich schon eine Verzögerung von 24 Sekunden über 100 Runden auf mehr als 40 Minuten. Zu den größten Hürden zählt Apheris aber die Daten selbst: Jede Firma hat ihre Strukturen über Jahrzehnte in eigenen Formaten gesammelt, und sie mussten auf ein gemeinsames Schema gebracht werden, ohne dass jemand zentral hineinsehen konnte.
Seit September 2026 läuft die nächste Initiative, AISB Bind: AbbVie, AstraZeneca, Bristol Myers Squibb und Johnson & Johnson trainieren ein Modell, das vorhersagen soll, wie fest kleine Moleküle an ihr Zielprotein binden. Eingebracht werden Strukturen, Affinitäts- und Potenzmessungen sowie Daten aus Hochdurchsatz-Screenings, die viele experimentell bestätigte Nichtbinder enthalten. Fertige Modelle erwartet Apheris Anfang 2027. Nach demselben Muster betreibt das Start-up seit Februar 2026 ein Netzwerk für ADMET-Vorhersagen (Aufnahme, Verteilung, Stoffwechsel, Ausscheidung, Toxizität), unter anderem mit Lundbeck, Orion Pharma, Recursion und Servier.
Datenschutz und IP: Was geschützt ist – und was nicht
Föderiertes Lernen ist kein Schutz-Automatismus. Auch Modellparameter und Gradienten tragen Informationen über die Trainingsdaten; Forscher zeigten bereits 2019 in der Arbeit „Deep Leakage from Gradients“, dass sich aus geteilten Gradienten unter Umständen Trainingsbeispiele rekonstruieren lassen. Apheris setzt deshalb auf mehrere Ebenen: Datenlokalität, erzwungen durch das Gateway, Rollentrennung zwischen Dateninhabern, Modellanbieter und Infrastrukturbetreiber, gemeinsame Regeln zur Nutzung der Daten und Verträge, die Rekonstruktionsangriffe untersagen. Die Dokumentation stellt zudem klar, dass der Schutz vom Modell abhängt: Bringt ein Teilnehmer ein eigenes Modell mit, ist dessen Autor für Schutzmechanismen wie zusätzliches Rauschen verantwortlich; Apheris übernimmt für Lecks durch solche Modelle keine Verantwortung und empfiehlt Dateninhabern, den Code zu prüfen.
Für AISB-1-Fed hat Apheris nach eigenen Angaben eine formale Risikoanalyse mit Rekonstruktions- und Membership-Inference-Angriffen unter angreiferfreundlichen Bedingungen durchgeführt und kein nennenswertes Risiko gefunden. Aufschlussreich sind die Zahlen: Der Membership-Inference-Angriff, der nur prüfen kann, ob eine dem Angreifer bereits vollständig bekannte Struktur im Training war, erreichte ohne einen einzigen Fehlalarm Trefferquoten zwischen etwa 5 und 32 Prozent. Apheris argumentiert, wer eine solche 3D-Struktur bereits besitze, erfahre nichts Neues. Eine unabhängige Prüfung dieser Analyse ist nicht veröffentlicht.
Beim geistigen Eigentum regelt der Vertrag die Grenzen: Vorhandenes und neu entstehendes geistiges Eigentum sind getrennt, die Gewichte eines Modells gehören den beteiligten Mitgliedern. Für Außenstehende heißt das: Weder Daten noch Modell sind öffentlich, veröffentlicht werden nur aggregierte Kennzahlen. Nature hatte schon im März 2025 darauf hingewiesen, dass das Werkzeug für akademische Forscher nicht offen sein wird. Personenbezogene Daten spielen bei AISB kaum eine Rolle; es geht um Betriebsgeheimnisse.
Grenzen der Aussagekraft
Einige Einschränkungen nennt Apheris selbst. Die Testdaten stammen von denselben fünf Firmen, deren Daten auch ins Training flossen – es handelt sich also nicht um einen vollständig externen Test, auch wenn die Aufteilung auf Projektebene erfolgte, damit eng verwandte Moleküle nicht in Training und Test landen. Wie ähnlich sich die Daten verschiedener Partner sind, lässt sich unter Föderation kaum messen, weil niemand alle Strukturen sieht. Gemessen wurde nur die Strukturvorhersage, nicht die Bindungsstärke, und der Benchmark ist bewusst auf industriell relevante Zielproteine zugeschnitten.
Dass Föderation spürbar hilft, ist zudem nicht selbstverständlich. Das dreijährige Projekt MELLODDY hatte zehn Pharmafirmen mit mehr als 2,6 Milliarden vertraulichen Messwerten per föderiertem Lernen zusammengebracht. Laut der 2023 veröffentlichten Auswertung verbesserten alle zehn ihre Modelle, die Leistung wuchs mit zusätzlichen Daten aber nur „in bescheidenem Tempo“ (im Original: „at a modest pace“). Apheris schreibt selbst, frühere Föderationsprojekte hätten nur moderate Gewinne gebracht. Der deutliche Sprung bei AISB-1-Fed ist deshalb das eigentliche Argument des Start-ups – belegt bislang durch eigene Messungen auf privaten Daten, die außer den Partnern niemand nachprüfen kann. Mit AISB Bind muss sich nun zeigen, ob sich das Ergebnis von der Struktur- auf die schwierigere Bindungsvorhersage übertragen lässt.
Quellen
- Handelsblatt: The Spark: Dieses Start-up bringt Pharma-Rivalen dazu, Daten zu teilen (08.11.2026, Bezahlschranke)
- Handelsblatt: The Spark: Alternative zu Nvidia? Technologiepreis für Photonikchips (06.11.2026, Bezahlschranke)
- Apheris: Federated Training Dramatically Improves the Accuracy of Protein-Ligand Co-folding on Private Pharma Structures (14.09.2026, aktualisiert 22.09.2026)
- Nature: Drug firms’ secret data supercharge AI protein models (14.09.2026)
- Apheris: A new operational standard for industrial federation (19.03.2026)
- Apheris-Dokumentation: Architecture und Privacy Controls (abgerufen 09.11.2026)
- Apheris: AI Structural Biology Network (abgerufen 09.11.2026)
- Apheris: AlQuraishi lab's OpenFold3 to Be Fine-Tuned with Pharma Industry Data (27.03.2025)
- Apheris: AISB Network Expands Federated OpenFold3 Initiative with Three New Pharma Contributors (01.10.2025)
- Apheris: AISB Network Launches AISB Bind (22.09.2026)
- Apheris: Apheris Launches ADMET Network (25.02.2026)
- TechCrunch: Apheris rethinks the AI data bottleneck in life science with federated computing (02.01.2025)
- Nature: AlphaFold is running out of data — so drug firms are building their own version (27.03.2025)
- arXiv: Zhu, Liu, Han – Deep Leakage from Gradients (21.06.2019)
- Journal of Chemical Information and Modeling (PMC): MELLODDY: Cross-pharma Federated Learning at Unprecedented Scale Unlocks Benefits in QSAR without Compromising Proprietary Information (2023)
Bildnachweis
- Aufmacher: Östrogenrezeptor alpha (Ligandenbindungsdomäne) im Komplex mit 4-Hydroxytamoxifen von Fanning, S.W., Greene, G.W., Lizenz CC BY 4.0, via Wikimedia Commons
- Inline: Protein Crystals (CSIRO ScienceImage 1600) von CSIRO, Lizenz CC BY 3.0, via Wikimedia Commons
