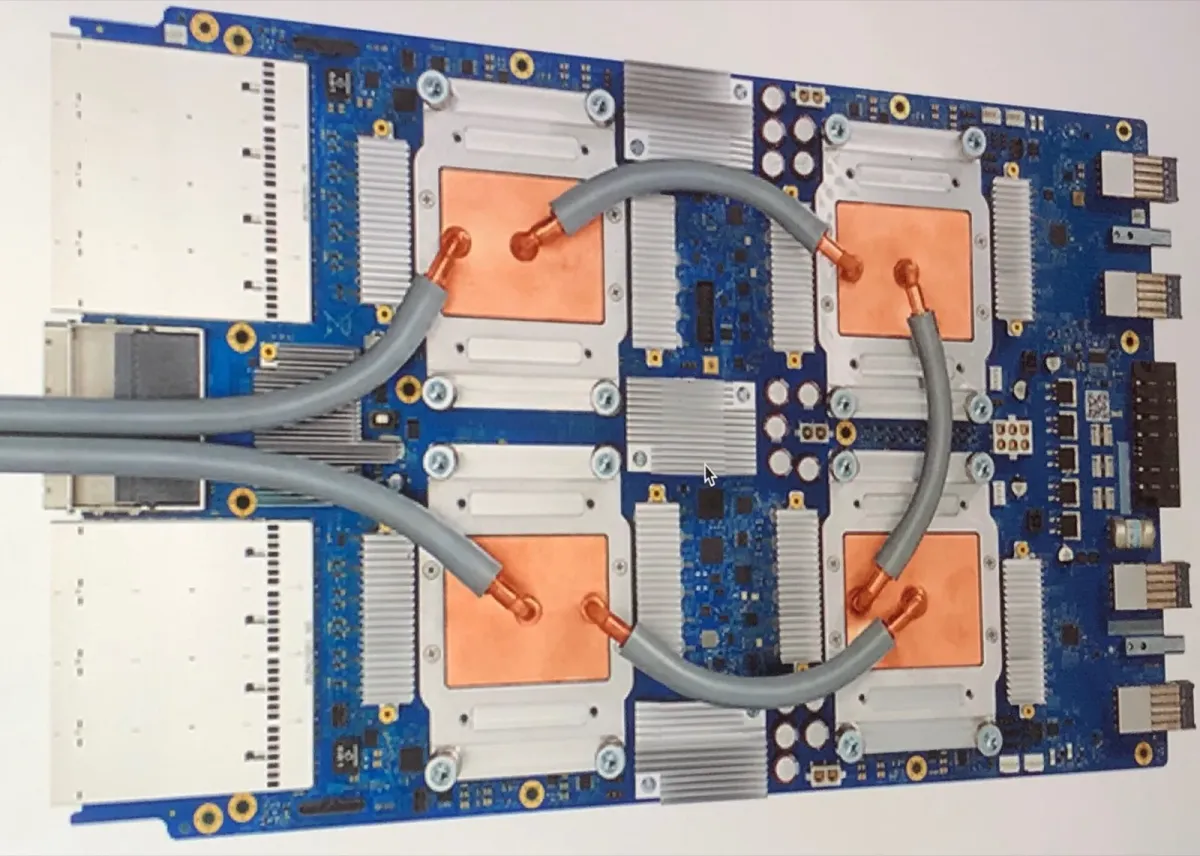
Google baut seine achte Generation von Tensor Processing Units (TPU) weiter aus. Am 9. November 2026 stellte der Konzern mit der TPU 8tx und der TPU 8i Max zwei zusätzliche Systeme vor. Die 8tx soll Daten und Modellgewichte auch während der Verarbeitung per Hardware abschirmen, die 8i Max vereint zwei Inferenz-Chips in einem Package und zielt auf sehr große Kontextfenster. Damit umfasst die Generation vier Systeme; laut Google ist es das erste Mal, dass der Konzern vier TPU-Systeme in einem Jahr vorstellt. Neue Chips sind die beiden Neuzugänge allerdings nicht: Sie kombinieren vorhandenes Silizium mit anderem Host, anderem Netzwerk oder anderer Verpackung.
Die Basis: TPU 8t fürs Training, TPU 8i für die Inferenz
Die achte Generation hatte Google im April auf der Konferenz Cloud Next erstmals in zwei Linien aufgeteilt. Die TPU 8t ist auf das Vortraining großer Modelle ausgelegt. Pro Chip nennt Google 12,6 Petaflops in FP4, 216 Gigabyte HBM mit 6528 Gigabyte pro Sekunde und 128 Megabyte SRAM auf dem Chip. In einem Superpod koppelt Google 9600 Chips in einem 3D-Torus, zusammen kommen sie auf 2 Petabyte HBM. Über das neue Rechenzentrumsnetz Virgo sollen sich mehr als 134.000 Chips in einem Netz verbinden lassen, mit der Software JAX und Pathways mehr als eine Million Chips in einem Trainingscluster.
Die TPU 8i zielt auf Inferenz, Post-Training und Reasoning. Sie bringt 288 Gigabyte HBM mit 8601 Gigabyte pro Sekunde und 384 Megabyte SRAM mit, dreimal so viel SRAM wie die Vorgängergeneration Ironwood; die Spitzenleistung liegt bei 10,1 Petaflops in FP4. Statt der SparseCores sitzt eine Collectives Acceleration Engine (CAE) auf dem Chip, die Synchronisationsschritte beim Erzeugen von Tokens beschleunigt; die Latenz solcher Operationen auf dem Chip sinkt laut Google um den Faktor fünf. Vernetzt werden bis zu 1152 Chips in der neuen Topologie Boardfly: Je vier Chips sind auf einem Board vollständig miteinander verbunden, acht Boards bilden eine Gruppe, und die Gruppen hängen über optische Schalter zusammen. Für einen Pod mit 1024 aktiven Chips sinkt der Netzwerkdurchmesser so laut Google von 16 auf 7 Hops. Das soll vor allem die All-to-All-Kommunikation beschleunigen, die bei Mixture-of-Experts-Modellen anfällt. Als Host-CPU dient bei 8t und 8i Googles eigener Arm-Prozessor Axion.
Leistungsvergleiche mit Ironwood gibt Google vor allem als Kosten- und Effizienzwerte an, und zwar als Herstellerangaben: Die 8t soll beim Training bis zu 2,7-mal so viel Leistung pro Dollar liefern, die 8i bei latenzkritischer Inferenz großer MoE-Modelle bis zu 80 Prozent mehr. Pro Watt sollen beide bis zu doppelt so effizient arbeiten. Allgemein verfügbar sind die beiden Basissysteme noch nicht: Auf Googles TPU-Produktseite stehen 8t und 8i mit Stand 9. November als „Bald verfügbar“.
TPU 8tx: Vertrauliche Inferenz mit AMD-Host
Die TPU 8tx nutzt dasselbe Silizium wie die 8t, ist aber für Inferenz auf sensiblen Daten konfiguriert. Üblicherweise sind Daten nur bei der Speicherung und Übertragung verschlüsselt und liegen während der Verarbeitung offen im Speicher. Die 8tx soll Daten und Modellgewichte dagegen auch im laufenden Betrieb per Hardware schützen und isolieren. Dafür wechselt Google den Host: Statt Axion arbeiten hier Epyc-Prozessoren der fünften Generation von AMD. Nach Angaben von AMD nutzt das System die Secure Encrypted Virtualization (SEV) der Epyc-CPUs und dehnt den Schutz zusammen mit der TPU über die CPU hinaus auf die angeschlossenen Beschleuniger aus. Laut Network World verschlüsselt Google zudem die Daten auf dem Weg vom Host zur TPU und attestiert das gesamte System. AMD bezeichnet die 8tx als erstes Cloud-TPU-System mit hardwaregestütztem Confidential Computing.
Damit schließt Google eine Lücke im eigenen Angebot. In der Dokumentation zu Confidential VMs heißt es bislang, TPUs ließen sich an solche Instanzen nicht anschließen, während vertrauliche VMs mit Nvidias H100-GPUs bereits verfügbar sind. Zielgruppe der 8tx sind laut Google regulierte Unternehmen und Behörden, die Spitzen- oder eigene Modelle und KI-Agenten zusammen mit ihren sensibelsten Daten betreiben. Weil die 8tx das latenzarme Boardfly-Netz der 8i übernimmt, soll sie gegenüber der 8t bis zu halb so lange Latenzen erreichen, der Schutz koste dabei nahezu keine Leistung. Neben der Inferenz will Google auf demselben System auch Feintuning mit privaten Daten, das Destillieren großer in kleinere Modelle und Reinforcement Learning ermöglichen, ohne sensible Daten zwischen Clustern verschieben zu müssen.
Bild: Googles Rechenzentrum im niederländischen Eemshaven, umgeben von Windrädern (Symbolbild). Foto: Wvdp / Wikimedia Commons, CC0

TPU 8i Max: Zwei Chips gegen die Speicherwand
Die TPU 8i Max richtet sich an Anwendungen, bei denen die Speicherbandbreite zum Engpass wird, etwa wenn viele KI-Agenten gleichzeitig eine ganze Codebasis oder stundenlanges Videomaterial verarbeiten. Google setzt dafür zwei 8i-Chips in ein gemeinsames Package. Rechenleistung, SRAM und HBM-Bandbreite verdoppeln sich gegenüber der 8i, rechnerisch also auf rund 20 Petaflops in FP4, 768 Megabyte SRAM und gut 17 Terabyte pro Sekunde. Beim HBM-Speicher selbst fällt der Zuwachs kleiner aus: Laut Network World sind es 384 Gigabyte, ein Drittel mehr als bei der 8i. Weil doppelt so viel Silizium auf dieselbe Rack-Grundfläche passt, verspricht Google deutlich mehr Rechenleistung pro Quadratmeter und pro Watt.
Software: PyTorch nativ, offene Werkzeuge
Parallel arbeitet Google daran, TPUs für Entwickler zugänglicher zu machen, die bisher auf Nvidias CUDA-Umgebung setzen. Seit Oktober ist TorchTPU quelloffen, damit laufen PyTorch-Code und Modelle von Hugging Face ohne Umschreiben auf TPUs, die Inferenz-Engines vLLM und SGLang haben TPU-Backends. Neu ist eine quelloffene Werkzeugsammlung für KI-Coding-Assistenten wie Claude Code, Cursor und Google Antigravity, die beim Einstieg helfen, Engpässe aufspüren und eigene Kernel automatisch optimieren soll; sie ist als Vorschau verfügbar. Ebenfalls quelloffen sind die XLA Serving Engine, die in Python trainierte Modelle in einer C++-Laufzeit auf TPUs, GPUs und CPUs ausliefert, sowie TPU Sync. Letzteres fasst HBM, Arbeitsspeicher des Hosts, gemeinsamen Speicher und Netzwerk zu einer Speicherhierarchie zusammen und lagert KV-Caches aus; die Zeit bis zum ersten Token soll dadurch um mehr als 90 Prozent sinken. Allgemein verfügbar sind nun Cloud Pathways und Dynamic Slicing in der Google Kubernetes Engine, das TPU-Verbünde per optischer Schaltung zur Laufzeit neu zusammensetzt. Jobs sollen so bis zu fünfmal schneller starten.
Einordnung: Ein wachsendes Geschäft, offene Fragen
TPUs sind für Google längst mehr als Eigenbedarf für die Gemini-Modelle. Laut Google nutzen inzwischen fast 100 Kunden die Beschleuniger, darunter KI-Labore, Handelsfirmen, Händler und Universitäten; Kunden können TPUs auch in eigenen Rechenzentren aufstellen. Im dritten Quartal wuchs der Umsatz von Google Cloud nach Alphabet-Angaben um 103 Prozent auf 30,7 Milliarden US-Dollar, Verkäufe von TPU-Systemen hätten spürbar dazu beigetragen.
Offen bleibt, wann Kunden die neuen Systeme nutzen können. Einen Termin und Preise für TPU 8tx und 8i Max nannte Google laut TechTarget und Network World nicht. Auch technische Details etwa zur Attestierung der 8tx fehlen in der Ankündigung. Sämtliche Leistungsangaben stammen von Google selbst; unabhängige Messungen der achten Generation gibt es noch nicht.
Quellen
- Google: Our newest TPUs: 8tx and 8i Max, built for the agentic era (09.11.2026)
- Google Cloud Blog: TPU 8t and TPU 8i technical deep dive (22.04.2026)
- Google Cloud: Tensor Processing Units, Produktseite (abgerufen 09.11.2026)
- AMD: AMD EPYC Expands Its Leadership at the Foundation of AI (09.11.2026)
- Google Cloud: Confidential VM, Supported configurations (abgerufen 09.11.2026)
- Alphabet: Alphabet Announces Third Quarter 2026 Results (28.10.2026)
- Network World: Google targets AI's next infrastructure bottlenecks with two new TPUs (09.11.2026)
- TechTarget: Google specializes TPUs for agentic, confidential computing (09.11.2026)
Bildnachweis
- Aufmacher: Tensor Processing Unit 3.0 (Symbolbild, Vorgängergeneration) von Zinskauf, Lizenz CC BY-SA 4.0, via Wikimedia Commons
- Im Text: Google data center and wind turbines in Eemshaven (Symbolbild) von Wvdp, Lizenz CC0, via Wikimedia Commons
