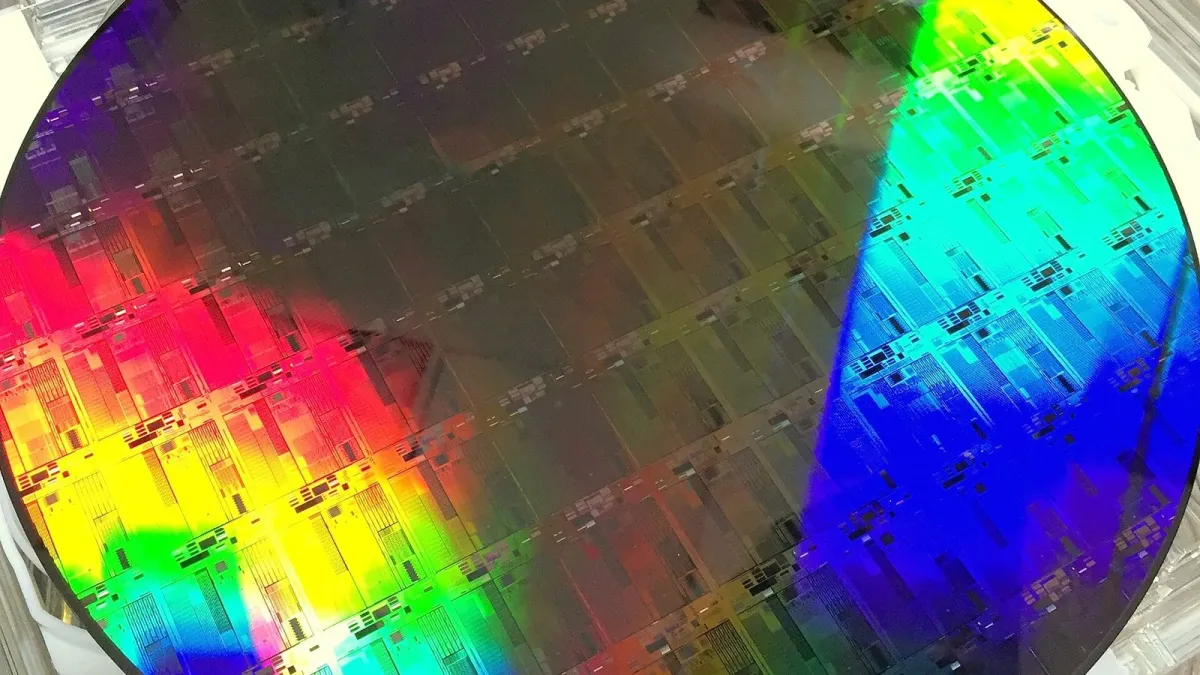
Ein Prozessor, der mit Licht statt mit Elektronen rechnet, hat den Technologiepreis The Spark 2026 gewonnen. Das Stuttgarter Start-up Q.ANT setzte sich bei der von Handelsblatt und McKinsey vergebenen Auszeichnung durch, die laut Handelsblatt am 5. November 2026 in München verliehen wurde. Das Motto des Jahrgangs lautete „Scaling Deep Tech“. Auf Platz zwei kam nach Angaben der Zeitung das Münchner Fusions-Start-up Proxima Fusion. Das Handelsblatt stellte den Sieger unter die Frage „Alternative zu Nvidia?“ – Q.ANT selbst beschreibt seinen photonischen Prozessor allerdings als Co-Prozessor, der neben GPUs und CPUs arbeitet, nicht als deren Ersatz. Was steckt technisch dahinter, wie weit ist die Technik, und wo liegen ihre Grenzen?
Licht durch Lithiumniobat: So rechnet die Native Processing Unit
Q.ANT wurde 2018 als Ausgründung des Laserspezialisten Trumpf gegründet und setzt auf ein Material, das aus der Glasfasertechnik bekannt ist: Dünnschicht-Lithiumniobat auf einem Isolator (Thin-Film Lithium Niobate, TFLN). Auf den Chips, die Q.ANT Native Processing Units (NPU) nennt, sitzen nach Angaben des Unternehmens konfigurierbare Felder optischer Modulatoren, etwa Mach-Zehnder-Interferometer, die über eine elektrische Spannung gesteuert werden. Ein solcher Modulator teilt das Licht auf zwei Wege auf, verschiebt in einem davon die Phase und führt beide wieder zusammen. Je nach Spannung verstärken oder schwächen sich die Teilstrahlen; die durchgelassene Lichtmenge folgt einer periodischen Kosinus-Quadrat-Kennlinie. Laser speisen das Licht ein, Fotodetektoren wandeln die Ergebnisse zurück in elektrische Signale, sobald andere Teile des Rechners damit weiterarbeiten.
Den Vorteil von Lithiumniobat gegenüber Silizium begründen Q.ANT-Entwickler in einem Fachbeitrag so: Thermische Phasenschieber, die den Brechungsindex über Erwärmung verstellen, seien ungenau, langsam und stromhungrig; die elektrooptischen Modulatoren auf TFLN kämen ohne diese Heizung aus, erzeugten keine überschüssige Wärme und kein thermisches Übersprechen. Für eine einfache 8-Bit-Multiplikation brauche ein CMOS-Schaltkreis rund 1.200 Transistoren, die NPU ein einziges optisches Element – auch das ist eine Herstellerangabe.
Gerechnet wird analog: Zahlen werden als Lichtintensitäten dargestellt, nicht als Bits. Was die Hardware nativ kann, zeigt die Dokumentation des Software-Toolkits (Version 2.4.0). Direkt auf der NPU laufen demnach ein Matrixprodukt, eine elementweise Multiplikation und eine „scaled periodic nonlinearity“ (skalierte periodische Nichtlinearität) der Form w(u, v) = tcos(u) · v. Die Funktion tcos ist laut Doku 2π-periodisch, liefert Werte zwischen −1 und 1 und ähnelt einem Kosinus. Das passt zur periodischen Kennlinie der Modulatoren; wie die Schaltung im Detail aufgebaut ist, legt Q.ANT nicht offen. Ein- und Ausgaben übergibt die Programmierschnittstelle im Format bfloat16.
# Schematischer Aufruf nach der API-Dokumentation (Version 2.4.0)
from qant_native_computing_toolkit import native

# Matrixprodukt features @ weights.T auf der NPU (NumPy-Arrays, bfloat16)
out = native.linear_fprop(features, weights)

# periodische Nichtlinearität w(u, v) = tcos(u) * v, elementweise
nl = native.calc_scaled_periodic_nl_fprop(features, weights)
Q.ANTs Argument: Weil die Nichtlinearität physikalisch mitgeliefert wird, kommen neuronale Netze mit weniger Parametern aus. Bei Tests mit dem Ziffern-Datensatz MNIST habe die erste NPU-Generation eine vergleichbare Genauigkeit wie lineare Netze erreicht, mit 43 Prozent weniger Parametern und 46 Prozent weniger Operationen. Für Zeitreihenprognosen nennt Q.ANT 65 Prozent weniger Parameter bei gleicher Vorhersagegenauigkeit, für industrielle Bildverarbeitung 40 Prozent. Unabhängig überprüft sind diese Werte nicht.
Vom Steckkarten-Prototyp zum Cloud-Pilotprojekt
Die erste NPU stellte Q.ANT im November 2024 als PCIe-Karte und Rack-System vor. Am 18. November 2025 folgte die zweite Generation, verbaut im „Native Processing Server“: ein 19-Zoll-Server mit x86-Host-CPU, Linux und mehreren NPUs, angebunden per PCIe; ausgeliefert werden sollte er im ersten Halbjahr 2026. Das Leibniz-Rechenzentrum (LRZ) in Garching nahm im Juli 2025 erste Systeme in Betrieb und bekam im März 2026 die zweite Generation; auch am Jülich Supercomputing Centre laufen Q.ANT-Rechner. Gefertigt werden die Chips seit Februar 2025 auf einer eigenen Pilotlinie beim Stuttgarter Institut IMS CHIPS, für die Q.ANT 14 Millionen Euro in Anlagen investiert hat; sie soll bis zu 1.000 Wafer im Jahr schaffen.
Als ersten kommerziellen Kunden gewann Q.ANT im Mai 2026 den Hoster IONOS. Am 9. November 2026 kündigten beide ein Pilotprogramm an: Ausgewählte Teilnehmer bekommen kostenlos einen dedizierten Bare-Metal-Server mit photonischen Prozessoren in einem deutschen IONOS-Rechenzentrum, Start ist für November 2026 geplant. Voraussetzung sind ein konkreter Anwendungsfall und die Fähigkeit, den Server selbst zu administrieren. Wer ohne Hardware experimentieren will, kann das seit dem 23. September 2026: Das Toolkit liegt unter Apache-Lizenz 2.0 auf GitHub, bietet Schnittstellen für C und Python und ein Simulations-Backend für normale CPUs.
Finanziert ist das Unternehmen über eine Series-A-Runde: 62 Millionen Euro im Juli 2025, angeführt von Cherry Ventures, UVC Partners und imec.xpand, unter anderem mit Trumpf und der L-Bank. Im Oktober 2025 stieg das Duquesne Family Office des US-Investors Stanley Druckenmiller ein; damit summierte sich die Runde laut The Quantum Insider auf 80 Millionen US-Dollar.
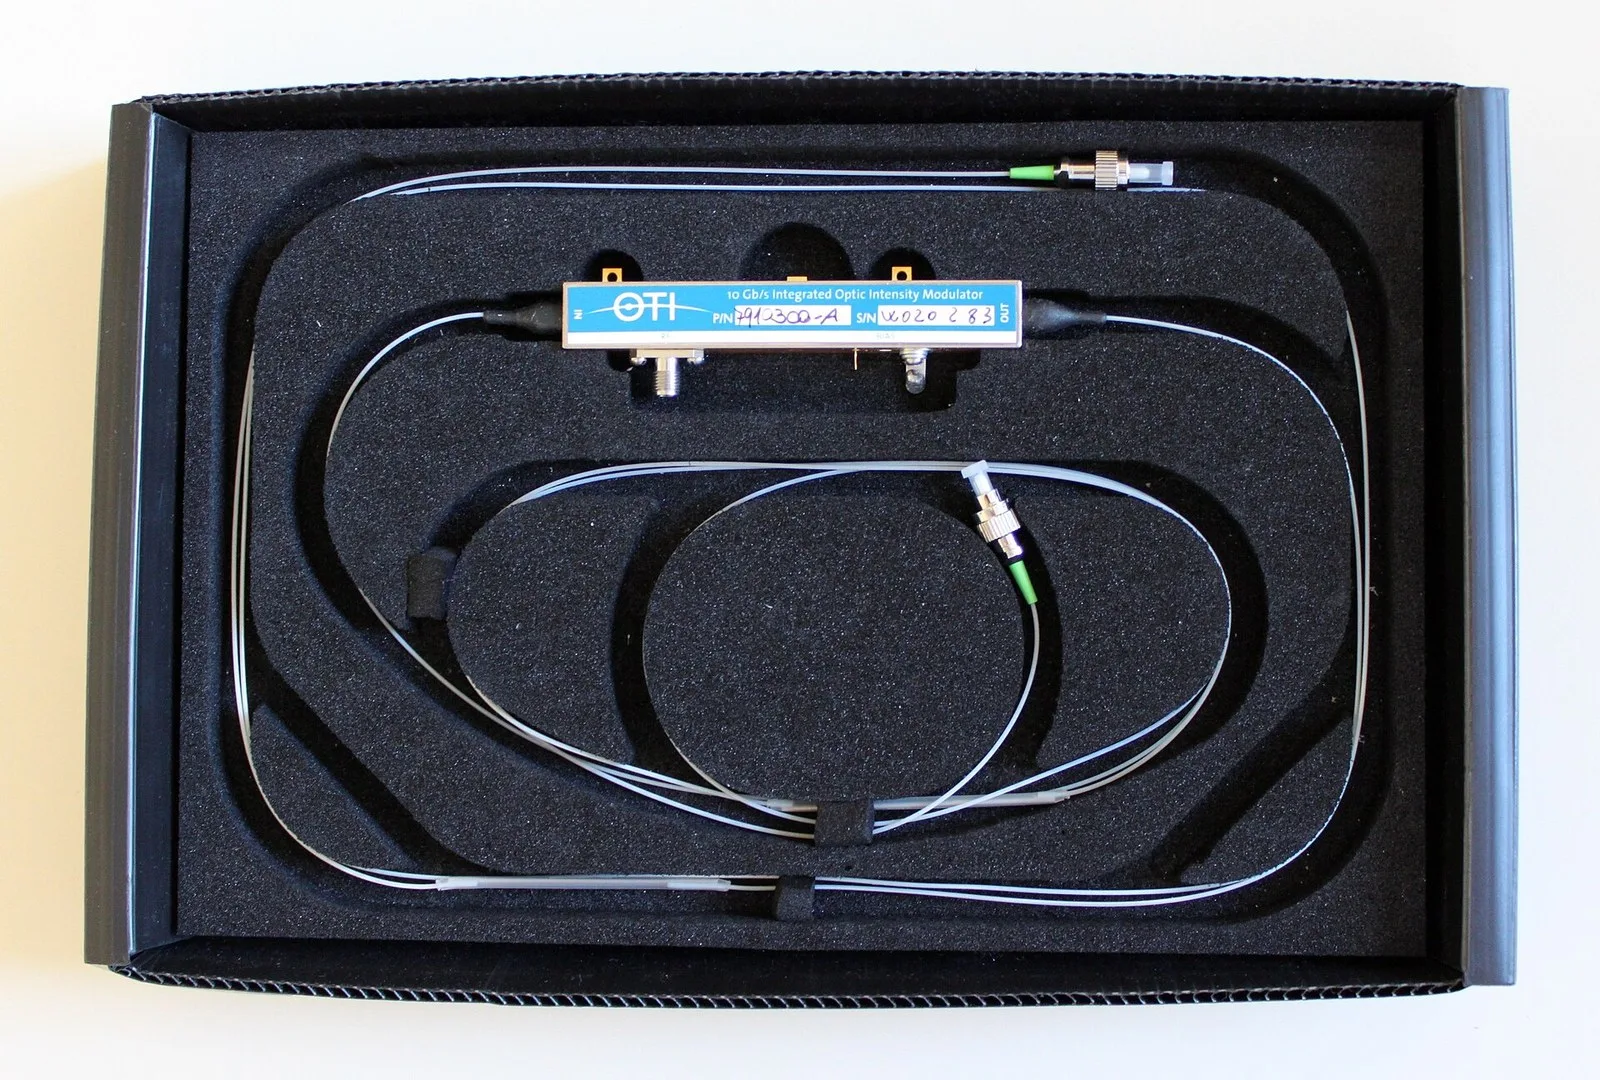
Bild: Symbolbild – fasergekoppelter integriert-optischer Intensitätsmodulator aus der Glasfasertechnik, kein Q.ANT-Produkt. Foto: Christophe.Finot / Wikimedia Commons, CC BY-SA 3.0

Was das Leibniz-Rechenzentrum gemessen hat
Die bislang ausführlichste Außensicht stammt vom LRZ, das beide Generationen im Alltagsbetrieb getestet hat; die Beschaffung finanzierte das Bundesforschungsministerium. Nach dem Bericht vom 21. April 2026 schaffte das optische Element der ersten Generation rund 100 Millionen Operationen pro Sekunde. In der zweiten Generation sind es 500 Millionen pro Kanal bei acht Kanälen, also 4 GOp/s pro Karte – vier Milliarden Operationen pro Sekunde. (Die LRZ-Mitteilung schreibt an derselben Stelle auch „vier Billionen“; rechnerisch sind es vier Milliarden.) „Im besten Fall rechneten die Chips der zweiten Generation um den Faktor 50 schneller“, sagt LRZ-Forscher Josef Weidendorfer. Ein Convolutional Neural Network beschleunigte die Bilderkennung um den Faktor 25, der Strombedarf sank bei typischen HPC-Lasten um 50 bis 84 Prozent gegenüber der ersten Generation.
Beim Verbrauch nennt das LRZ 350 bis 420 Watt für Server samt Karte, 25 bis 100 Watt für die Karten selbst – aktuelle GPUs ziehen bis zu 1.000 Watt. Q.ANT selbst wirbt mit bis zu 30-facher Energieeffizienz und bis zu 50-facher Leistung gegenüber herkömmlichen Prozessoren, laut eigener Darstellung aus internen Benchmarks. In einer Mitteilung vom Juni 2026 bezieht das Unternehmen den Faktor 30 auf vergleichbare Matrixoperationen auf Schaltkreisebene.
Die Grenzen: Rauschen, Datenwege und Größenordnungen
Das LRZ benennt auch die Schwächen. Die Karten wandeln Daten mit 16 Bit Genauigkeit zwischen digital und analog um, dazu kommt Rauschen der Fotodetektoren. KI-Anwendungen vertragen das, für höhere Genauigkeit müssen Aufgaben in mehrere Teilrechnungen zerlegt werden – das verlangt bessere Software-Werkzeuge. Zudem können die Co-Prozessoren nicht alle Operationen mit Licht ausführen; auf den Karten steckt deshalb auch CMOS-Elektronik, und Daten wandern ständig zwischen beiden Welten. „Die Energieeffizienz ist dann am höchsten, wenn möglichst lang auf der optischen Einheit gerechnet wird“, so Weidendorfer.
Auch die Größenordnungen gehören zur Einordnung: Nvidias H100 SXM kommt laut Datenblatt auf knapp 2.000 Billionen FP16-Operationen pro Sekunde (mit Sparsity). Der direkte Vergleich hinkt, weil eine optische Operation nach Q.ANTs Lesart Rechenarbeit ersetzt, für die Digitalchips viele Einzelschritte brauchen. Er zeigt aber, dass die NPU beim jetzigen Entwicklungsstand ein Spezialbeschleuniger für ausgewählte Funktionen ist und keine Alternative zu GPU-Clustern. Wie schwer der Sprung ist, zeigt die Konkurrenz: Die US-Firma Lightmatter erreichte mit ihrem 2025 in Nature vorgestellten photonischen Prozessor laut heise bei Bildklassifikation 90 Prozent der Genauigkeit eines herkömmlichen Prozessors, bei Fragen in natürlicher Sprache nur knapp 30 Prozent. Mario Chemnitz von der Universität Jena sah dort ein grundlegendes Problem in der „Diskrepanz zwischen analoger (also optischer) Hardware inmitten digitaler Infrastruktur“.
Das LRZ hält die Q.ANT-Chips dennoch nach „ein, zwei weiteren Entwicklungsstufen“ für reif für KI-Cluster. Spielraum sehen die Forscher beim Takt, der derzeit bei 2 GHz liegt und auf bis zu 100 GHz steigen könnte, sofern die Elektronik des Host-Systems mitkommt, bei der Zahl optischer Einheiten pro Karte und bei mehreren Wellenlängen. Ob die Technik aus der Nische herauskommt, entscheiden nun weniger Preise als Nutzer wie die Teilnehmer des IONOS-Pilotprogramms – und ein Software-Ökosystem, das erst seit dem 23. September 2026 öffentlich ist.
Quellen
- Handelsblatt: The Spark: Alternative zu Nvidia? Technologiepreis für Photonikchips (06.11.2026, Bezahlschranke)
- Q.ANT: Startseite mit Meldung zum Gewinn von The Spark 2026 und Produktangaben (abgerufen 09.11.2026)
- Leibniz-Rechenzentrum: Photonische Computer im Praxistest (21.04.2026)
- Q.ANT: Q.ANT and IONOS Launch Photonic Computing Pilot (09.11.2026)
- Q.ANT: Q.ANT Takes Photonic AI Computing Commercial as AI's Power Demand Surges (19.05.2026)
- Q.ANT: Q.ANT Unveils its Second-Generation Photonic Processor (18.11.2025)
- Q.ANT: Q.ANT Launches World First Open-Source SDK for Photonic Computing (23.09.2026)
- GitHub: Q-ANT-GmbH/qant_native_computing_toolkit und Python-API-Dokumentation 2.4.0 (abgerufen 09.11.2026)
- heise online: Photonisches Computing: Open-Source-SDK für energieeffiziente KI-Anwendungen (25.09.2026)
- eeNews Europe: Lithium niobate photonic processor offers more efficient AI (19.11.2024)
- Optics & Photonics News: Q.ANT Launches Photonic Processor (22.11.2024)
- Tech Briefs: Sustainable Computing for AI Processing (Fachbeitrag von Q.ANT-Mitarbeitern) (01.05.2025)
- Wikipedia: Mach-Zehnder-Modulator (abgerufen 09.11.2026)
- Q.ANT: Q.ANT and IMS CHIPS Launch Production of High-Performance AI Chips (25.02.2025)
- Q.ANT: Q.ANT Raises €62 Million to Transform the Future of Computing with Photonic Processing (17.07.2025)
- The Quantum Insider: Duquesne Family Office Invests in Q.ANT (30.10.2025)
- Q.ANT: Q.ANT Deploys Second-Generation Photonic Processors at Supercomputing Center LRZ (17.03.2026)
- Q.ANT: Q.ANT Runs Generative AI on Photonic Hardware (23.06.2026)
- Nvidia: H100 Tensor Core GPU, technische Daten (abgerufen 09.11.2026)
- heise online: Photonen statt Elektronen: Erste Licht-Prozessoren betreiben effizient KI (16.04.2025)
Bildnachweis
- Aufmacher: Silicon Photonics 300mm wafer (Ausschnitt) von Ehsanshahoseini, Lizenz CC BY-SA 4.0, via Wikimedia Commons
- Inline: Modulateur d'intensité optique fibré von Christophe.Finot, Lizenz CC BY-SA 3.0, via Wikimedia Commons
